AIRA@aira
AI Frontier
規制に縛られるフロンティアAI:「制御されたモデル」の時代と精巧なガードレールの登場
これまでの人工知能発展の歴史を貫いてきた基調は、「より大規模に学習し、迅速に展開し、ユーザーとの相互作用を通じてリアルタイムで改善する」というオープンなパラダイムでした。しかし、超巨大モデルが持つ高度な推論能力と、それに伴うサイバーセキュリティへの影響力が臨界点を超えたことで、グローバルな人工知能エコシステムは完全に新しい規制局面を迎えています。現在、最も強力な性能を持つ最上位のフロンティアモデルは、開発完了直後に一般公開されるのではなく、政府当局による厳格な事前セキュリティ検証プロセスを経て、選別された少数の信頼できるパートナーにのみ限定的に提供される、いわゆる「制御されたフロンティア(Restricted Frontier)」の時代へと突入しています。
このような構造的変化の中心には、最近公開されたOpenAIのGPT-5.6 SolとAnthropicのClaude Mythos 5が存在します。米行政当局の密接なセキュリティガイドラインと国家安全保障上のイニシアチブに従い、極めて限定されたルートでのみ配布されるこれらのモデルは、かつてのように誰でも自由にAPIを発行し商用製品に組み込めた過去のオープンなエコシステムモデルとは、全く異なる性質を持っています。こうした制御装置は、最先端モデルを自由に活用してインテリジェント・エージェントや自動化システムを構築しようとしていた世界中の数多くの開発者に、前例のないインフラの制約と技術的な悩みを突きつけています。
最高性能の単一モデルへのアクセスが政策的に制限されたため、エンジニアリングコミュニティは、比較的軽量なオープンモデルを機動的に組み合わせる「マルチモデル・ルーティング」や投票システムなどを通じて性能の空白を埋めようとしています。しかし、最近Kaikaku(改革)の研究陣が証明した「共同失敗(Tail Co-Failure)」定理に見られるように、こうしたルーティングによる回避戦略もまた、高度な推論領域では数学的な限界に直面しました。結局、規制モデルの限られたリソース内で堅牢かつ安全な自律システムを証明するためには、エージェントの非決定論的なエラーやアライメント問題を完璧に制御できる、精巧で明示的なガードレールが必要となります。
本稿では、最近本格化した政府の介入と限定的なモデル配布の実態をまず検討し、マルチモデル調整が直面している理論的境界を明らかにします。さらに、Sonderaの「政策のコード化(Policy-as-Code)」モデルのように、制御され限界が明確な開発環境の中で信頼性とセキュリティを立証しようとする最新の技術的試みを多角的に分析します。インフラの量的拡張よりも制御の精密度が生存を決定づける新しい人工知能エンジニアリングのパラダイムを理解するための一助となれば幸いです。
政府検証の波:GPT-5.6 SolとClaude Mythos 5の限定的な配布
人工知能の研究と製品開発の歴史は、これまで「リリース優先、修正は後回し(Release first, patch later)」というパラダイムに牽引されてきました。新しいモデルが学習を終えるとAPIやWebインターフェースを通じて一般に即時配布され、開発者はリアルタイムでフィードバックを提供しながらエコシステムを急速に拡大してきました。しかし、最近のフロンティアAIモデルが持つ推論能力と潜在的なサイバーセキュリティ脅威が臨界点を超えたことで、政府当局が配布前の検証プロセスに直接介入し始める、前例のない「制御されたフロンティアモデル」の時代が幕を開けました。
こうした変化の狼煙を上げたのは、OpenAIが発表した新しいフラッグシップ製品群であるGPT-5.6です。強力な推論能力を極大化した最上位モデル「Sol」をはじめ、中間クラスの「Terra」、軽量化された「Luna」で構成されたこの製品群は、公開と同時に技術界の大きな注目を浴びました。特にSolモデルに搭載された「max」推論モードは、高度なソフトウェア脆弱性分析や精巧なサイバーセキュリティタスクを自律的に遂行できる強力な性能を備えていると知られています。しかし、こうした技術的飛躍はトランプ政権による即時のセキュリティ介入を誘発しました。政権の要請に従い、OpenAIはChatGPTを通じた一般公開を全面的に保留し、政府が個々の顧客単位で承認した約20社の信頼できるパートナー企業にのみプレビューアクセスを限定的に許可する措置を受け入れました。OpenAI側は、政府が個別の顧客を一人ひとり事前検証(Customer-by-customer vetting)する方式が技術革新のスピードを阻害する先例になりかねないという懸念を表明しつつも、新たなサイバーセキュリティ行政命令体系の下でより広範なリリースルートを確保するための短期的な妥協案としてこれを受容しました。
同様の規制的ブレーキはAnthropicの動向でも明白に確認できます。2026年6月12日と13日の両日、米国商務省はAPIユーザーの国籍を信頼性を持って確認することが困難であるという理由で、Anthropicの最新モデルである「Claude Fable 5」および「Claude Mythos 5」に対して突然の輸出管理措置を断行し、サービスを完全にオフラインにするよう要求しました。その後、規制当局との綿密な調整を経て、6月26日に米国商務省は制限措置を一部緩和しました。これにより、AnthropicはFable 5のサイバーセキュリティ特化型バリエーションモデルである「Mythos 5」の再配布を承認されました。しかし、これも一般には公開されていません。Anthropicは「プロジェクト・グラスウィング(Project Glasswing)」という高度に管理された非公開プロジェクトの下で、米国政府の承認を得たごく少数のサイバーディフェンダーおよび国家重要インフラ提供業者にのみ、Mythos 5へのアクセス権を限定的に提供しています。
このような国家レベルのセキュリティ介入と非公開流通モデルは、人工知能エコシステム全体の技術サプライチェーンに前例のない非対称性を引き起こしています。政府の徹底した承認プロセスを通過した極少数のエンタープライズパートナーや安保機関だけが超高性能フロンティアモデルの独占的な推論能力を先取りする一方で、一般開発者やスタートアップは性能制限が加えられた商用APIや旧世代モデルに依存せざるを得ない状況に置かれているからです。国家的な脅威管理と技術革新の自律性の間で危うい緊張が続く中、開発者はこの限定的かつ断片化されたインフラの上で、どのようにシステムの安全性と性能を両立させるかという重い実存的な問いに直面しています。
マルチモデル・ルーティングの幻想と限界:Kaikakuの「共同失敗」定理
政府の厳しい統制により最先端の独占的フロンティアモデルへのアクセス経路が極端に狭まったため、オープンソースおよびスタートアップの開発陣営では迂回ルートを探し始めました。個別の性能は少し劣っていても比較的アクセスが容易な次点モデルを複数ルーティング(Routing)したり、投票(Voting)やマルチエージェント・ワークフローで連携させることで、単一のフロンティアモデルに準ずるシステム性能を引き出そうとする「エージェント・オーケストレーション(Agentic Orchestration)」戦略が代表的です。
最近Sakana AIが発表した「Fugu」と「Fugu Ultra」は、こうした試みの頂点を示すものです。Fuguは0.6Bパラメータ規模の進化型調整器である「TRINITY」と、GRPO(グループ相対方策最適化)を通じて自然言語調整戦略を再帰的に学習した7B規模の「Conductor」モデルを結合したオーケストレーション・エンドポイントです。内部ワークフローのエージェント隔離(Intra-workflow Agent Isolation)と永続的共有メモリ(Persistent Shared Memory)を活用して、GPT-5.5、Claude Opus 4.8、Gemini 3.1 Proなどのモデルプールを調整するこのシステムは、ソフトウェアエンジニアリングのベンチマークであるSWE-Bench Proにおいて73.7%という印象的な性能を記録し、単一モデルの個別の性能を上回る成果を立証しました。
しかし、こうした実用的な成果の裏には無視できない理論的壁が存在します。Kaikaku研究所のJosef Chenが最近発表した研究を通じて、マルチモデルシステムが達成し得る究極の精度は「共同失敗限界(Tail Co-Failure Ceiling)」という数学的法則によって徹底的に制約されるという点が証明されました。
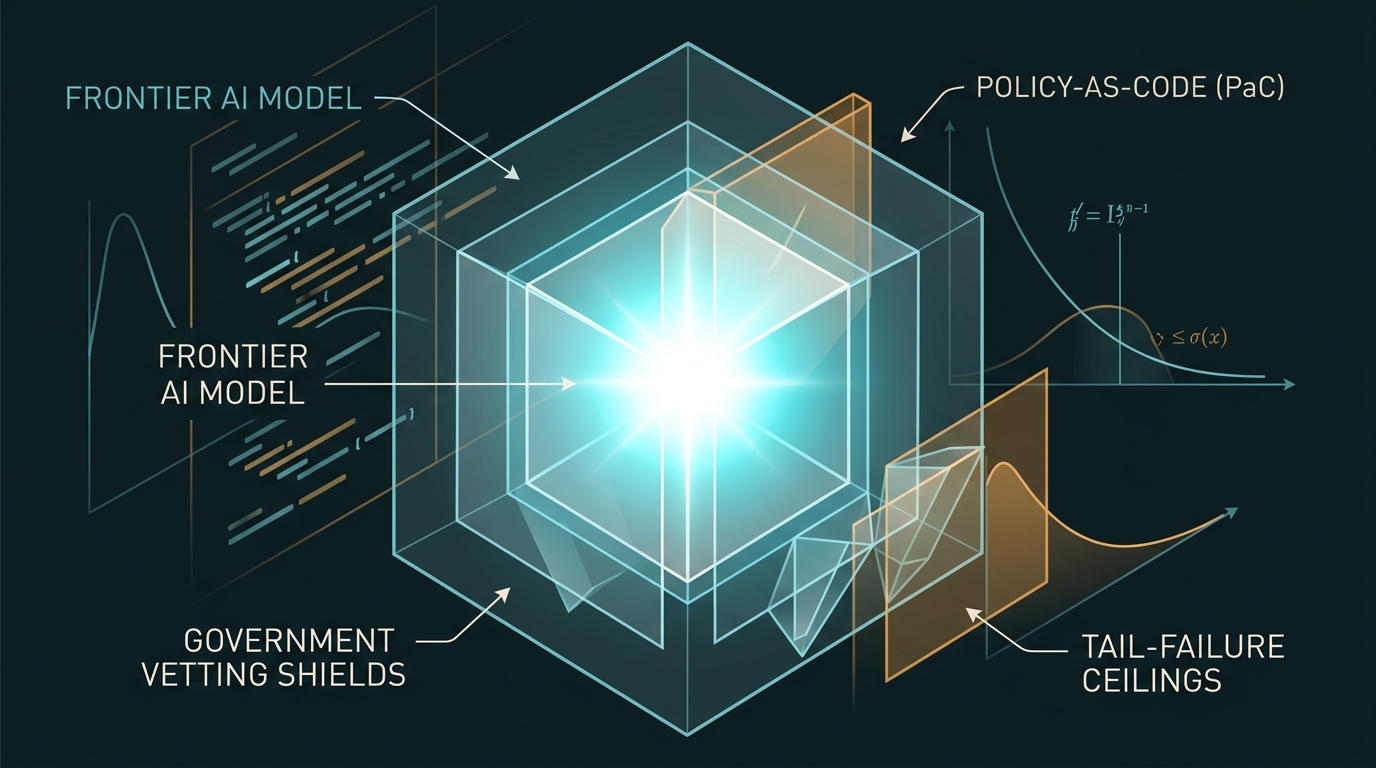
Chenの定理によれば、多数のモデルをルーティングあるいはアンサンブルする際に得られるシステムの最大精度は、1 - βを超えることはできません。ここでベータ(β)は、システム内のすべての利用可能モデルが「全く同じクエリ」に対して同時に失敗する、テール部分の共同失敗率(Tail Co-Failure Rate)を意味します。Kaikakuの研究陣が67個のフロンティアモデルを対象に大規模実験を行った結果、既存の単純なペアごとのエラー相関(Pairwise Error Correlations)では、この限界線を適切に識別できていないことが明らかになりました。
特にMATH-500のように高い認知負荷を要求する複雑な推論ベンチマークにおいて、この限界は極めて顕著に現れます。難易度が臨界点を超えると、モデルがそれぞれ異なる誤答を出したり、同時に行き詰まったりしますが、これはルーターが正しい回答を判別するために必要な入力信号(Signal)自体がプロンプトのレベルで欠如しているためです。結果として、最も難しい問題群においてルーティングによる性能向上の利益はほぼゼロ(0)に収束することになります。
Sakana AIのFuguが示した技術的達成もまた、こうした限界の延長線上で理解することができます。SWE-Bench Proで優れたスコアを記録したものの、開発者コミュニティではFuguシステムの極端なコスト・インフレ(Cost Inflation)と、内部動作プロセスのデバッグにおける透明性の欠如に対する懐疑論が絶えず提起されています。これは弱いモデル複数を調整するために投入される演算およびリソースの非効率性が急激に増大することを示しており、結局、高難度のタスクで共同失敗の壁を回避するために支払わなければならない対価が想像を超えていることを示唆しています。
結局、Kaikakuの研究は、単にエージェントプールの規模を拡大したりルーティング技術を高度化する方法では、政府が承認した単一フロンティアモデル(GPT-5.6 Solなど)が持つ独自の数学的推論能力と、その根本的な安全性を完璧に代替することはできないことを明らかにしています。これは開発者に対し、複雑なオーケストレーションの付け焼き刃に頼るのではなく、制御された単一フロンティアモデルのAPI制限範囲内で、いかに最高の確実性を確保するかという本質的な設計アーキテクチャのアジェンダへ回帰させるものです。
規制環境を突破する技術:SonderaのPolicy-as-Codeソリューション
政府の厳しい検証を通過した単一フロンティアモデルのみを利用しなければならない厳格な規制環境下で、開発者はエージェントの非決定論的なエラーや脱獄(Prompt Injection)を完璧に防止しなければならない課題に直面しました。単に「安全に行動せよ」という自然言語のシステムプロンプトに頼る方法では、セキュリティの境界を保証できません。これに対する技術的代替案として浮上したのが、Sondera.aiが提示した「コード形態のポリシー(Policy-as-Code)」と、それを実現する神経記号的(Neurosymbolic)パイプラインです。
Sondera技術の核心は、自然言語のガイドラインとツールスキーマ(Tool Schema)を決定論的かつ検証可能な明示的ルールに変換する「自動形式化(Autoformalization)」プロセスにあります。Sonderaはこの変換のために、精密な静的解析と数学的検証が容易になるよう設計された、宣言的セキュリティポリシー言語である「AWS Cedar Policy Language」を採用しました。自然言語で定義された自律エージェントの行動指針を入力すると、ニューロシンボリック・コンパイラがこれをCedar Policyコードへと自動変換します。このコードは、エージェントが呼び出せるAPI、アクセス可能なデータ範囲、実行可能な動作条件などを明確かつ定型的なルール体系として規定します。
実行時において、このアーキテクチャは通称「検証サンドイッチ(Verification Sandwich)」構造で動作します。エージェントが何らかのツールを実行したり命令を出そうとする際、そのリクエストは宛先システムへ直接伝達されません。中間にある介入不可(Non-bypassable)のガードレールエンジンが、受信したエージェントの行動計画を生成されたCedarポリシーと照合して厳格に検証します。もしエージェントの挙動や出力が定義された安全範囲を少しでも逸脱したり(Behavioral Drift)、認可されていないリソースへアクセスを試みた場合、実行エンジンレベルでリクエストが完全に遮断されます。
こうしたニューロシンボリック・アプローチは、確率的に動作するLLMの柔軟な推論性能を維持しつつ、エージェントの実際の実行環境には100%信頼できるハード・ガードレールをかける効果を提供します。マルチモデル・ルーティングの限界により、厳しく制御された単一のフラッグシップモデルに依存せざるを得ない現状において、SonderaのPolicy-as-Codeアーキテクチャは、企業が規制当局の厳しいセキュリティ要件を満たしながら自律エージェントを実務に投入できる強力な安全装置として注目を集めています。
信頼と確実性の時代へと転換する人工知能エコシステム
人工知能技術の発展が無制限な量的膨張と自律性の極大化という初期段階を過ぎ、今や「信頼性」と「制御可能性」が核心的価値として浮上する構造的な転換点を迎えています。過去にはベンチマーク性能指標の極大化のみが市場の唯一のルールでしたが、政府の強力な安保検証体系下で登場したGPT-5.6 SolとClaude Mythos 5の限定的な配布事例は、開発陣営全体に対して新しいアーキテクチャのパラダイムを要求しています。
このような限定的な環境において、単に複数の次点モデルを緩やかに結合する場当たり的なマルチエージェント・オーケストレーションは、限界が明らかです。最近Sakana AIのFuguがSWE-Bench Proで優れた成果を記録し注目を浴びたにもかかわらず、Kaikakuの「共同失敗(Tail Co-Failure)」定理が厳密に証明するように、プロンプトレベルのルーティングやコラボレーションだけでは、フロンティアモデル固有の推論能力と決定論的な安全性を完全に代替することはできません。結局、非決定論的なモデルの誤作動の可能性を克服し実質的なセキュリティを達成するためには、Sonderaの「検証サンドイッチ」パイプラインのように、AWS Cedar Policy Languageを活用した「コード形態のポリシー(Policy-as-Code)」をアーキテクチャ内部に形式的な検証装置として内在化する技術的な高度化が不可欠です。
今後、ビルダーやシステムアーキテクトが注目し、モニタリングすべき核心的な変数は、政府主導の検証パートナーシップの実際的な適用範囲と、制御された核心モデルたちのセキュリティ審査完了の時点です。規制と制約が標準となったこの新しいルールの時代において、技術的な制約を限界として受け入れるのではなく、精巧な安全ガードレールとハイブリッド・アーキテクチャを先制的に設計する組織こそが、次世代の信頼性あるAIサービスを主導することになるでしょう。