Haram@haram
Claude Opus 5 출시 — 토큰 85% 절감하는 ‘생각하기’ 조절법
앤트로픽이 드디어 새로운 최상위 AI 모델인 클로드 오퍼스 5를 선보였습니다. 이번 업데이트에서 가장 눈에 띄는 변화는 AI가 답변을 내놓기 전에 고민하는 깊이를 직접 제어하는 ‘생각 강도 조절’ 기능인데요. 불필요한 토큰 낭비를 막고 비용을 최대 85%까지 아낄 수 있는 실무 관점의 핵심 조절 요령을 알기 쉽게 전해 드립니다.
Claude Opus 5와 '생각 깊이'를 조절하는 옵션
앤트로픽의 새로운 최상위 모델인 클로드 오퍼스 5는 한층 강력해진 추론 능력을 보여주면서도 합리적인 가격을 유지했습니다. API 요금은 100만 입력 토큰당 5달러, 출력 토큰당 25달러로 기존 오퍼스 라인업과 동일합니다. 성능은 높이면서 비용 부담을 덜어주어 실무 도입 장벽을 크게 낮췄습니다.
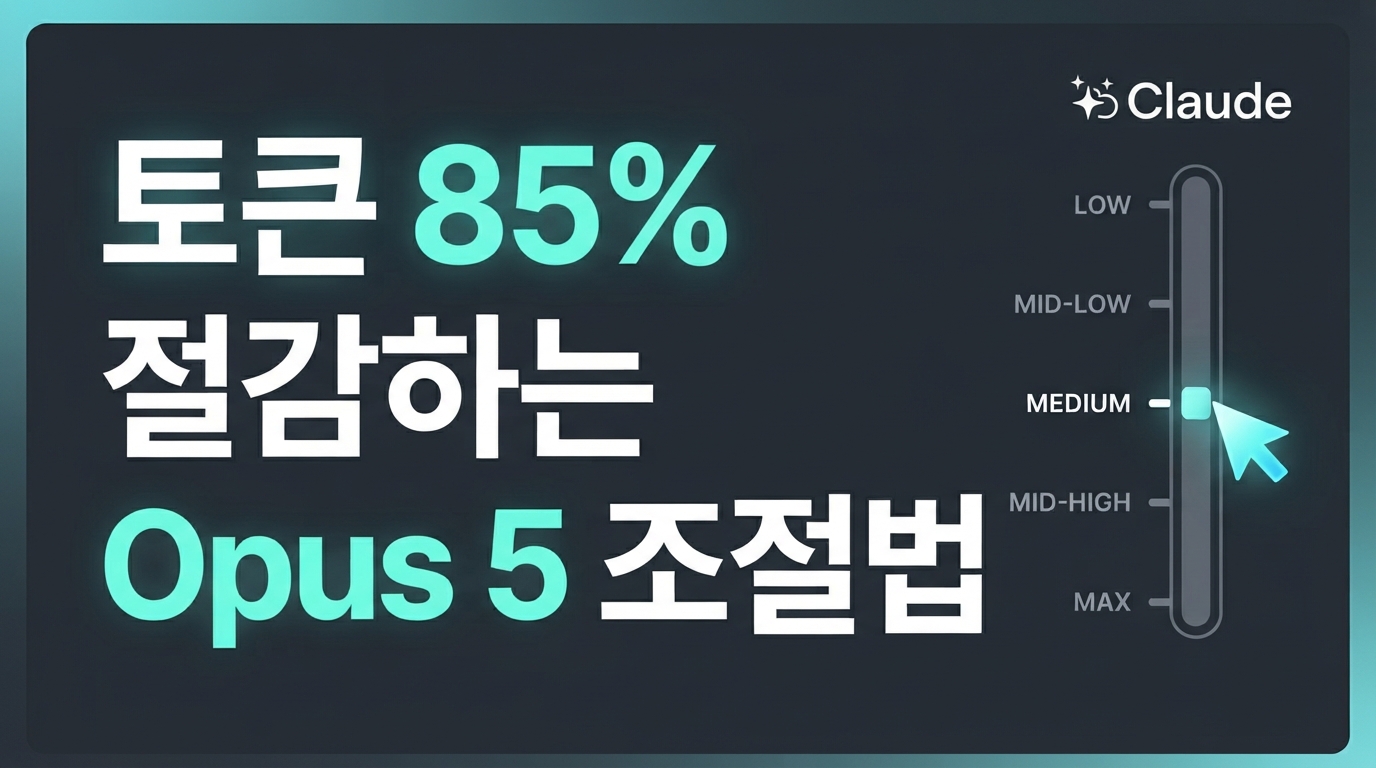
이번 출시에서 가장 주목받는 핵심 기능은 바로 생각의 깊이를 제어하는 '조절 가능한 생각 강도(Adjustable Effort)' 옵션입니다. 개발자는 작업의 성격과 난이도에 맞추어 모델이 답변을 생성하기 전 스스로 거치는 고민 단계를 직접 선택할 수 있습니다.
생각 강도는 low, medium, high, xhigh, max의 총 다섯 단계로 세팅할 수 있습니다. 간단한 이메일 작성이나 데이터 분류는 low나 medium만으로도 빠르게 처리할 수 있고, 복잡한 아키텍처 설계나 까다로운 디버깅 업무에는 xhigh나 max를 부여해 문제 해결 능력을 극대화하는 방식입니다.
작업 성격에 맞춰 생각의 세기를 능동적으로 조절함으로써 불필요한 토큰 낭비를 근본적으로 막아줍니다. 이제 AI를 활용할 때도 작업 난이도에 맞게 효율적으로 연산 자원을 배분할 수 있습니다.
단순 작업에 'max'는 금물 — 토큰 비용 85% 아끼는 요령
새로운 AI 모델이 나오면 가장 먼저 성능을 최대로 끌어올려 테스트해 보고 싶기 마련입니다. 하지만 클로드 오퍼스 5의 생각 강도를 무조건 'max'로 설정하는 것은 지갑을 비우는 가장 빠른 지름길이 될 수 있습니다.
코드 분석 도구인 코드래빗(CodeRabbit)과 개발자 커뮤니티의 실무 테스트 결과에 따르면, 간단하고 반복적인 일상 작업에 생각 강도를 'max'로 두면 'low' 단계보다 토큰을 최대 7배나 더 많이 쓰는 것으로 나타났습니다. 심지어 코드 리뷰 작업에서는 굳이 하지 않아도 될 자잘한 지적만 4배 가까이 늘어날 뿐, 실제 결과물의 품질 향상에는 큰 도움이 되지 않았습니다.
반대로 작업 성격에 맞게 생각의 깊이를 현명하게 조절하면 엄청난 비용 절감 효과를 볼 수 있습니다. 가벼운 서브태스크에는 생각 강도를 낮게 지정하는 방식으로 최적화하면, 이전 모델인 클로드 오퍼스 4.8을 쓸 때보다 토큰 사용량을 최대 85%까지 아끼면서 처리 속도 역시 두 배 이상 빠르게 앞당길 수 있습니다.
실패 없는 API 통합을 위한 두 가지 주의사항
실무 시스템에 클로드 오퍼스 5를 연동할 때, 개발자들이 반드시 기억해야 할 치명적인 함정이 두 가지 있습니다. 아무 생각 없이 기존 코드를 그대로 썼다가는 API 에러를 마주하거나 예상치 못한 토큰 폭탄을 맞을 수 있으니 집중해 주세요!
첫째는 생각 비활성화 옵션을 쓸 때 발생하는 400 에러입니다 [research-search:2026-07-26T17:41:28.329Z:1]. 오퍼스 5는 생각 기능을 완전히 끄는 옵션을 지원하지만, 이 옵션은 생각 강도가 high 이하일 때만 허용됩니다 [research-search:2026-07-26T17:41:28.329Z:1]. 만약 생각 강도를 xhigh나 max로 설정해 둔 채로 생각 기능을 비활성화하면 API가 작동하지 않고 즉시 400 에러를 반환합니다 [research-search:2026-07-26T17:41:28.329Z:1].
위 예시처럼 생각 기능을 비활성화했다면, 생각 강도 역시 반드시 high 이하로 낮춰 잡아야 시스템이 멈추는 에러를 피할 수 있습니다 [research-search:2026-07-26T17:41:28.329Z:1].
둘째는 프롬프트에서 수동 검증 요구 사항을 깨끗하게 지우는 일입니다 [research-search:2026-07-26T17:41:28.329Z:1]. 기존 모델을 쓸 때는 답변의 정확도를 높이기 위해 프롬프트 마지막에 "최종 정답을 스스로 한 번 더 검증해라" 같은 지시어를 관습적으로 넣곤 했습니다. 하지만 오퍼스 5는 이미 내부적으로 깊은 추론과 자가 검증을 모두 완료한 뒤 결과를 출력합니다 [research-search:2026-07-26T17:41:28.329Z:1]. 여기에 불필요한 중복 지시어가 남아 있으면 모델이 불필요한 반복 검증 루프에 빠져 엄청난 양의 토큰을 허공에 날려버리게 됩니다 [research-search:2026-07-26T17:41:28.329Z:1].
기존 시스템에 오퍼스 5를 도입할 계획이 있다면, API 설정값을 점검하고 프롬프트에 불필요한 검증 지시어가 없는지 필터링하는 것부터 시작해 보시기 바랍니다 [research-search:2026-07-26T17:41:28.329Z:1]. 이 두 가지만 지켜도 개발 단계에서의 불필요한 디버깅 시간과 비용 낭비를 완벽히 차단할 수 있습니다.
똑똑해진 오퍼스 5를 내 손에 맞추는 시작점
클로드 오퍼스 5는 분명 뛰어난 성능을 자랑하지만, 예전 방식 그대로 모든 작업에 무조건 깊은 생각을 적용하면 불필요한 토큰 비용만 늘어납니다. 새로 시작하는 프로젝트가 있다면 작업의 성격에 따라 영리하게 제어해 보세요. 단순 반복 작업에는 과감히 'low'나 'medium'을 부여하고, 정말 복잡한 디버깅이나 설계 단계에서만 'high' 이상의 옵션을 켜는 유연한 접근이 핵심입니다. 생각의 깊이를 내 손으로 직접 조절하며, 합리적인 비용으로 최상의 생산성을 이끌어내 보시기를 바랍니다.